
Machine Learning vs estadística tradicional
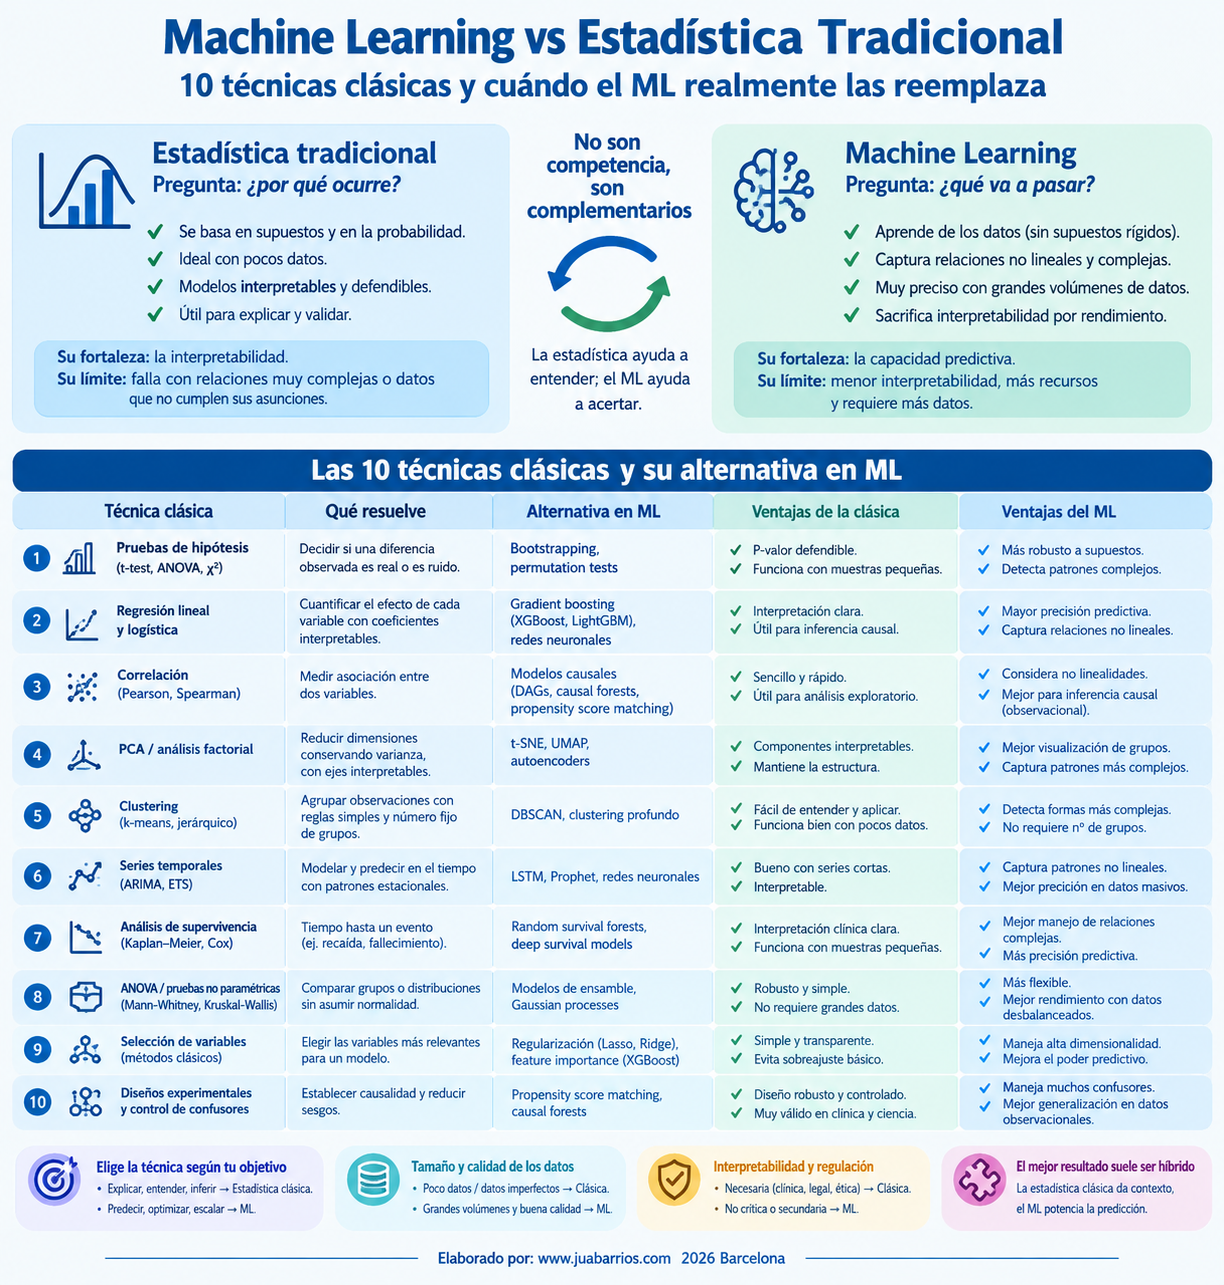
Machine Learning vs estadística tradicional: 10 técnicas clásicas y cuándo el ML realmente las reemplaza
Hace un par de semanas escribí sobre los tipos de desviación estándar y qué puede estar ocultando la sigma de tu paper. La pregunta que me quedó dando vueltas después de ese artículo fue otra: si ya sabemos calcular la incertidumbre de un dato, ¿para qué necesitamos machine learning? La respuesta corta es que Machine Learning vs estadística tradicional no es una competencia real, sino dos herramientas que resuelven preguntas distintas — y confundirlas lleva a elegir mal la técnica en más proyectos de los que uno quisiera admitir.
Este artículo es para quien ya maneja estadística y quiere entender, técnica por técnica, cuándo un método clásico sigue siendo la mejor opción y cuándo conviene reemplazarlo por su equivalente en ML.
¿Qué es la estadística tradicional?
Nace en el siglo XIX y XX ligada a la necesidad de sacar conclusiones sobre una población a partir de una muestra pequeña: censos, ensayos agrícolas, estudios clínicos. Su pregunta central es por qué ocurre algo. Para responderla, asume una estructura en los datos (una distribución normal, una relación lineal) y calcula qué tan probable es que el patrón observado sea real y no producto del azar.
Esa asunción de estructura es su fortaleza y su límite al mismo tiempo. Con pocos datos, funciona mejor que casi cualquier alternativa. Con datos que no cumplen esas asunciones, empieza a fallar de formas difíciles de detectar si no se audita el modelo.
¿Qué es el Machine Learning?
El término se usa desde 1959, pero su despegue real llegó con la disponibilidad de datos masivos y capacidad de cómputo barata. Su pregunta central es qué va a pasar, no por qué. Un modelo de gradient boosting puede predecir con precisión si un paciente reingresará en 30 días sin que nadie —ni el propio modelo— pueda explicar con claridad qué combinación de variables lo determina.
Esa renuncia a la interpretabilidad no es un descuido: es una decisión de diseño. El ML acepta modelos más complejos y opacos a cambio de capturar relaciones no lineales que la estadística clásica simplemente no puede representar con una fórmula cerrada.
Machine Learning vs estadística tradicional: la diferencia real
Esta distinción no es mía: la formalizó el estadístico Leo Breiman en «Statistical Modeling: The Two Cultures» (2001), separando la «cultura del modelo de datos» de la «cultura algorítmica». Resumido en una frase: la estadística tradicional optimiza para entender, el machine learning optimiza para acertar. Uno construye un modelo que un humano pueda inspeccionar y defender delante de un comité de ética. El otro construye un modelo que funcione, aunque su lógica interna sea una caja opaca de millones de parámetros.
Ninguna de las dos es superior en abstracto. La estadística tradicional pierde cuando la relación entre variables es demasiado compleja para una fórmula simple. El machine learning pierde cuando el dataset es chico, cuando hay que justificar cada coeficiente ante un regulador, o cuando el costo de un error no puede compensarse con una ganancia promedio en precisión.
Cómo se complementan en la práctica
En proyectos reales rara vez se elige una sola. Un flujo típico en salud digital usa estadística clásica para el análisis exploratorio y para validar que las variables tienen sentido clínico, y reserva el ML para el modelo final de predicción, una vez que ya se entendió la estructura de los datos. La estadística hace de control de calidad; el ML hace el trabajo pesado de predicción a escala.
10 técnicas clásicas y su alternativa en ML
Técnica clásica |
Qué resuelve | Alternativa en ML | Cuándo la clásica sigue ganando |
|---|---|---|---|
| Pruebas de hipótesis (t-test, ANOVA, χ²) | Decidir si una diferencia observada es real o es ruido | Bootstrapping, permutation tests | Muestras pequeñas y cuando se necesita un p-valor defendible para publicar |
| Regresión lineal y logística | Cuantificar el efecto de cada variable con coeficientes interpretables | Gradient boosting (XGBoost, LightGBM), redes neuronales | Cuando el objetivo es explicar un efecto, no solo predecirlo |
| Correlación (Pearson, Spearman) | Medir asociación entre dos variables | Modelos causales (DAGs, causal forests, propensity score matching) | Ninguna de las dos resuelve causalidad sin un diseño experimental detrás |
| PCA / análisis factorial | Reducir dimensiones conservando varianza, con ejes interpretables | t-SNE, UMAP, autoencoders | Cuando hay que explicar qué representa cada componente, no solo visualizar grupos |
| Clustering (k-means, jerárquico) | Agrupar observaciones con reglas simples y número fijo de grupos | DBSCAN, clustering profundo | Datasets pequeños o cuando el número de grupos debe tener sentido clínico |
| Series temporales (ARIMA, Holt-Winters) | Modelar tendencia y estacionalidad con pocos parámetros | Prophet, LSTM, transformers | Series cortas, donde un modelo profundo no tiene datos suficientes para aprender |
| Supervivencia (Kaplan-Meier, Cox) | Estimar tiempo hasta un evento con datos censurados | Random survival forests, deep survival models | Muestras limitadas donde se necesita interpretar el hazard ratio |
| Diseño experimental y tamaño muestral | Calcular cuántos sujetos hacen falta antes de empezar | Bandits multi-brazo, optimización bayesiana adaptativa | Ensayos regulados donde el protocolo debe fijarse de antemano |
| Corrección por comparaciones múltiples (Bonferroni, FDR) | Controlar falsos positivos al testear muchas hipótesis a la vez | Regularización L1/L2 (Lasso, Ridge) | Cuando el objetivo es inferencia confirmatoria, no minimizar error de predicción |
| Bootstrapping / remuestreo | Estimar incertidumbre sin asumir una distribución | Validación cruzada (k-fold, leave-one-out) | Comparten la misma lógica: usar los datos que ya tenés para simular los que no tenés |
Vale la pena detenerse en la última fila. El bootstrapping y la validación cruzada no son técnicas rivales — son la misma idea aplicada a dos preguntas distintas: una estima incertidumbre, la otra estima error de predicción. Es probablemente el punto donde estadística tradicional y machine learning están más cerca de fusionarse en una sola disciplina.
El caso de la correlación merece la misma aclaración. Ni un p-valor de 0.001 ni un modelo de ML con 95% de precisión prueban causalidad por sí solos. Ese es un error que cruza las dos culturas por igual, y probablemente el más caro cuando aparece en un paper o en una decisión clínica.
Ventajas de cada enfoque
Estadística tradicional:
- Coeficientes interpretables y defendibles ante un comité o un regulador
- Funciona con muestras pequeñas, algo habitual en investigación clínica
- Teoría matemática sólida detrás de cada intervalo de confianza
Machine Learning:
- Captura relaciones no lineales que ninguna fórmula cerrada puede representar
- Escala a millones de registros y cientos de variables sin perder desempeño
- Se adapta cuando llegan datos nuevos, sin rehacer el modelo desde cero
Conclusión
Si me preguntan en un pasillo de la facultad cuál es mejor —y me lo preguntan más seguido de lo que imaginan— contesto siempre lo mismo: depende de la pregunta, no de la moda. Llevo años en este tema como para haber visto el mismo error dos veces: alumnos que le «meten» una red neuronal a un dataset de 40 pacientes porque «el ML es la moda», y les sale un modelo que memorizó los datos, y no que aprendió de ellos. Con 40 pacientes, un modelo de Cox bien planteado te dice más de lo que va a decirte cualquier red.
Y al revés también pasa, eh. He revisado papers donde alguien fuerza una regresión lineal sobre una relación que a simple vista es curva, solo para poder reportar un R² bonito. Ninguna de las dos culturas —ni la de Breiman, ni la mía, ni la tuya— tiene el monopolio de hacer las cosas mal.
Mi consejo, primero aprendé a hacerte la pregunta correcta. La técnica viene después, casi sola.
En resumen: La discusión de Machine Learning vs estadística tradicional pierde sentido en cuanto se la plantea como una elección única. La pregunta correcta no es cuál técnica es mejor, sino qué pregunta estás tratando de responder: si es por qué, casi siempre gana la estadística; si es qué va a pasar, casi siempre gana el ML. Las diez comparaciones de arriba son un punto de partida para decidir caso por caso, no una tabla de sustitución automática.
Sobre el autor: el autor es Dr. Juan Ignacio Barrios, es médico y cirujano especialista en informática médica. Tiene maestrías en Big Data, Ciencia de Datos, Business Intelligence e Inteligencia Artificial. Colabora como profesor invitado en las cátedras del grado y del posgrado en Ingeniería Biomédica de la Universidad de Barcelona (facultades de Física y Medicina). Es también consultor "senior" de organizaciones y empresas del ámbito público y privado, y faculty member de la Universidad de Rochester (NY, Estados Unidos de Norteamérica).